 ID010
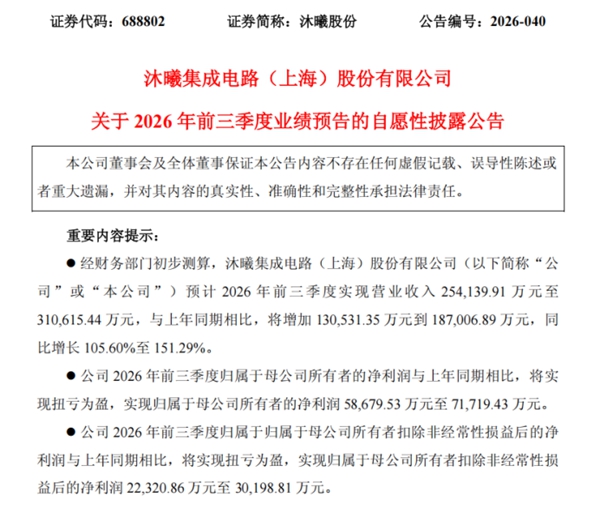
沐曦股份(688802)10月15日披露2026年前三季度业绩预告,预计2026年前三季度实现营业收入25.41亿元至31.06亿元,同比增长105.60%至151.29%;预计实现归属于母公司所有者的净利润5.87亿元至7.17亿元,同比扭亏为盈;扣除非经常性损益后归母净利润预计为2.23亿元至3.02亿元,同样实现大幅扭亏。
对于业绩大幅改善的原因,公司表示,报告期内坚持“1+6+X”发展战略,持续加大市场开拓力度,不断提升在高性能GPU行业的市场地位与影响力;凭借优越的产品性能及完善的软件生态,公司产品及服务获得下游客户的广泛认可与持续采购,收入规模较上年同期显著增长,同时对产业链上公司的投资收益也对利润形成贡献。
产品性能与生态建设,正是业绩改善背后的技术支撑。
硬件上,曦云C系列GPU基于自主XCORE架构,搭载大容量高带宽显存与MetaXLink高速片间互联,具备强大混合精度算力与优秀集群线性扩展能力,天然适配MoE混合专家模型架构、百万Token长上下文推理的算力与显存需求,单机多卡与大规模智算集群均可稳定承载,兼顾训推一体化,覆盖模型微调、验证到推理部署全流程。
软件上,MXMACA全栈软件栈覆盖底层驱动、MXCC编译器、深度优化算子库与主流AI框架适配层,原生兼容主流开发生态,可将传统大模型适配周期从数周压缩至小时级,大幅降低迁移成本。
依靠软硬件一体的产品矩阵,沐曦股份在通用性与兼容性上具有显著优势。自2025年12月以来,公司GPU计算平台已完成超过40个主流旗舰开源模型的Day 0适配,范围涵盖智谱、阿里千问、MiniMax、DeepSeek、阶跃星辰、腾讯混元等头部模型厂商,适配速度、数量与生态广度均位居行业前列。
值得一提的是,10月15日,阶跃星辰最新开源新一代旗舰基座模型Step 5 Preview,沐曦股份曦云C系列GPU率先完成Day 0深度适配,以全栈自研算力底座,为国产Agent生态再添核心支撑,持续领跑国产大模型极速适配赛道。
从行业背景来看,当前国产高性能GPU正处于需求持续释放的窗口期。大模型迭代与多模态应用渗透持续拉动AI训练与推理算力需求,各地智算中心建设、重点行业智能化升级以及国产替代进程加速,为具备自研芯片与成熟软件栈能力的本土GPU厂商提供了更大的市场空间。沐曦股份GPU产品已在人工智能训练、推理及科学计算等场景落地应用,后续随着产品矩阵进一步完善、生态适配持续推进,有望持续受益于国内算力基础设施建设和自主可控需求的释放。
 微信扫一扫打赏
 支付宝扫一扫打赏